

第四章 智能体经典构建
Yang
Yang
AI+网络安全笔记
2026年6月24日 14:42
北京
在小说阅读器读本章
去阅读
在上一章节里,我们剖析了大语言模型作为现代智能体核心“大脑”的运作机制,深入学习了其Transformer架构原理、交互方式及其固有的能力局限。现在,是时候跨越理论的桥梁,将这些认知付诸实践,亲手打造属于我们的智能体。
现代智能体的核心竞争力,在于其能够将大模型内在的推理能力与外部环境有效连通。它具备了自主解析用户意图、拆解复杂任务结构的能力,并能通过调用代码解释器、搜索引擎及各类API接口等“工具箱”,来实现信息的获取与操作的执行,从而达成最终目标。当然,智能体并非无所不能,它同样受限于大模型本身的“幻觉”缺陷,在处理复杂逻辑时可能陷入死循环,或出现工具调用的误操作,这些构成了其实际应用的边界。
为了更科学地组织智能体的“思维”与“行动”流程,业界发展出了多种经典的架构模式。本章将聚焦于其中最具代表性的三种架构,并带领读者从零开始逐一实现:
-
ReAct (Reasoning and Acting): 一种强调“知行合一”的范式,促使智能体在思考中行动,在行动中动态调整策略。
-
Plan-and-Solve: 一种推崇“谋定后动”的范式,要求智能体先构建完整的行动蓝图,随后按部就班地执行。
-
Reflection: 一种赋予智能体“自省能力”的范式,通过内部的自我批判与修正机制来迭代优化结果。
了解了上述背景,或许你会疑惑:既然市面上已有LangChain、LlamaIndex等成熟的开发框架,为何还要费力去“重复造轮子”?原因在于,虽然成熟的封装极大地提升了工程效率,但过度依赖高度抽象的工具,往往会让我们对底层的设计逻辑与运行机制一知半解。其次,亲手构建的过程会让我们直面各类工程挑战。框架在底层默默处理了诸多细节,诸如模型输出格式的解析容错、工具调用失败后的重试机制、以及如何防止智能体陷入死循环等。亲自解决这些问题,是磨炼系统设计思维最直接的途径。最后,也是最关键的一点,只有洞悉了设计原理,你才能完成从框架“使用者”到应用“创造者”的身份蜕变。当标准组件无法满足你的定制化需求时,你将具备深度定制乃至从零构建全新智能体的底气。
4.1 环境准备与基础工具定义
在正式开工之前,我们需要先搭建好开发环境,并定义一组基础组件。这将确保我们在后续实现不同架构时,能够复用代码,从而集中精力攻克核心逻辑。
4.1.1 安装依赖库
本书的实战环节主要基于 Python 语言,推荐使用 Python 3.10 及以上版本。首先,请确保安装了 openai 库以便与大语言模型进行交互,同时安装 python-dotenv 库来安全管理 API 密钥。 在终端中执行以下指令:
pip install openai python-dotenv
4.1.2 配置 API 密钥
为了保证代码的通用性,我们将模型服务相关的配置(模型ID、密钥、服务地址)统一放置在环境变量中管理。 在项目的根目录下,新建一个名为 .env 的配置文件。 在文件中填入以下内容。你可以根据实际情况,将其配置为 OpenAI 官方服务,或任何兼容 OpenAI 接口的第三方/本地服务。 若不清楚如何获取,可参考“环境配置”章节。
# .env file
LLM_API_KEY=\"YOUR-API-KEY\"
LLM_MODEL_ID=\"YOUR-MODEL\"
LLM_BASE_URL=\"YOUR-URL\"
后续代码将自动从该文件读取这些配置信息。
4.1.3 封装基础 LLM 调用函数
为了提升代码的整洁度与复用性,我们来定义一个专属的LLM客户端类。该类将封装所有与模型服务交互的底层细节,使主逻辑能更专注于智能体的构建。
import os
from openai import OpenAI
from dotenv import load_dotenv
from typing import List, Dict
# 加载 .env 文件中的环境变量
load_dotenv()
classHelloAgentsLLM:
    \"\"\"
    为本书 \"Hello Agents\" 定制的LLM客户端。
    它用于调用任何兼容OpenAI接口的服务,并默认使用流式响应。
    \"\"\"
    def__init__(self, model: str = None, apiKey: str = None, baseUrl: str = None, timeout: int = None):
        \"\"\"
        初始化客户端。优先使用传入参数,如果未提供,则从环境变量加载。
        \"\"\"
        self.model = model or os.getenv(\"LLM_MODEL_ID\")
        apiKey = apiKey or os.getenv(\"LLM_API_KEY\")
        baseUrl = baseUrl or os.getenv(\"LLM_BASE_URL\")
        timeout = timeout or int(os.getenv(\"LLM_TIMEOUT\", 60))

        ifnot all([self.model, apiKey, baseUrl]):
            raise ValueError(\"模型ID、API密钥和服务地址必须被提供或在.env文件中定义。\")
        self.client = OpenAI(api_key=apiKey, base_url=baseUrl, timeout=timeout)
    defthink(self, messages: List[Dict[str, str]], temperature: float = 0) -> str:
        \"\"\"
        调用大语言模型进行思考,并返回其响应。
        \"\"\"
        print(f\"正在调用 {self.model} 模型...\")
        try:
            response = self.client.chat.completions.create(
                model=self.model,
                messages=messages,
                temperature=temperature,
                stream=True,
            )

            # 处理流式响应
            print(\"大语言模型响应成功:\")
            collected_content = []
            for chunk in response:
                ifnot chunk.choices:
                    continue
                content = chunk.choices[0].delta.content or\"\"
                print(content, end=\"\", flush=True)
                collected_content.append(content)
            print()   # 在流式输出结束后换行
            return\"\".join(collected_content)
        except Exception as e:
            print(f\"调用LLM API时发生错误: {e}\")
            returnNone
# --- 客户端使用示例 ---
if __name__ == '__main__':
    try:
        llmClient = HelloAgentsLLM()

        exampleMessages = [
            {\"role\": \"system\", \"content\": \"You are a helpful assistant that writes Python code.\"},
            {\"role\": \"user\", \"content\": \"写一个快速排序算法\"}
        ]

        print(\"--- 调用LLM ---\")
        responseText = llmClient.think(exampleMessages)
        if responseText:
            print(\"\
\
--- 完整模型响应 ---\")
            print(responseText)
    except ValueError as e:
        print(e)
>>>
--- 调用LLM ---
正在调用 xxxxxx 模型...
大语言模型响应成功:
快速排序是一种非常高效的排序算法...
4.2 ReAct
在准备好LLM客户端后,我们将着手构建第一个,也是最经典的一种智能体范式——ReAct (Reason + Act)。ReAct范式由Shunyu Yao于2022年提出[1],其核心理念在于模仿人类解决问题的路径,将推理与行动显式地串联结合,构建起一个“思考-行动-观察”的闭环。
4.2.1 ReAct 的工作流程
在ReAct问世之前,主流方法主要分为两派:一派是“纯思考”型,例如思维链,它能引导模型进行深层逻辑推演,但无法触达外部世界,容易产生事实性幻觉;另一派是“纯行动”型,模型直接输出动作指令,却缺乏规划与纠错机制。 ReAct的高明之处在于,它认识到思考与行动是相辅相成的。思考为行动指明方向,行动的结果反过来又修正思考。为此,ReAct范式通过特定的提示工程引导模型,使其每一步输出都遵循固定轨迹:
Thought (思考): 这是智能体的“内心独白”。它负责分析现状、拆解任务、规划下一步,或反思上一步的结果。
Action (行动): 这是智能体决定采取的具体手段,通常指向一个外部工具调用,例如 Search['华为最新款手机']。
Observation (观察): 这是执行 Action 后从外部工具返回的反馈,例如搜索摘要或API响应。****
*智能体将不断循环 Thought -> Action -> Observation 过程,将新的观察追加到历史记录中,形成不断增长的上下文,直到它在 Thought 中判定任务完成,进而输出结果。这一过程形成了强大的协同效应:*推理赋予了行动目的性,而行动为推理提供了事实支撑。我们可以将这一过程形式化表达,如图4.1所示。具体而言,在每个时间步 ,智能体的策略(即大语言模型 )会依据初始问题 和历史轨迹 ,生成当前的思考 和行动 :
随后,环境中的工具 执行行动 ,并返回新的观察 :
这一循环持续进行,将新的 对追加到历史中,直到模型在思考 中判断任务终结。
图 4.1 ReAct 范式中的“思考-行动-观察”协同循环
这种机制在以下场景中表现尤为出色:
- 需要外部知识的任务:如查询实时资讯(天气、新闻、股价)、检索专业领域知识等。
- 需要精确计算的任务:将数学运算交给计算器工具,规避LLM的计算错误风险。
- 需要与API交互的任务:如操作数据库、调用特定服务接口完成功能。 因此,我们将构建一个具备外部工具调用能力的ReAct智能体,来回答一个仅凭大模型知识库无法直接解答的问题:“华为最新的手机是哪一款?它的主要卖点是什么?”这要求智能体意识到需要联网搜索,调用工具获取结果并进行总结。
4.2.2 工具的定义与实现
若将大语言模型比作智能体的大脑,那么工具便是其与外界交互的“四肢”。为了让ReAct范式真正发挥作用,我们需要赋予智能体调用外部工具的能力。 针对本节目标,我们需要为智能体配备一个网页搜索工具。这里我们选用 SerpApi,它通过API提供结构化的Google搜索结果,能直接返回“答案摘要框”或知识图谱信息。 首先,安装该库:
pip install google-search-results
同时,你需要前往 SerpApi官网 注册免费账户获取API密钥,并将其添加到项目根目录的 .env 文件中:
# .env file
# ... (保留之前的LLM配置)
SERPAPI_API_KEY=\"YOUR_SERPAPI_API_KEY\"
接下来,我们通过代码定义并管理这个工具。我们将分步实施:先实现核心功能,再构建通用管理器。
(1)实现搜索工具的核心逻辑一个定义良好的工具应包含三个核心要素:
- 名称:简洁唯一的标识符,供智能体在
Action中调用,如Search。 - 描述:清晰的自然语言功能说明。这是关键,模型依赖此描述判断何时调用。
- 执行逻辑:真正执行任务的函数或方法。 我们的首个工具是
search函数,负责接收查询词并返回结果。
from serpapi import SerpApiClient
defsearch(query: str) -> str:
    \"\"\"
    一个基于SerpApi的实战网页搜索引擎工具。
    它会智能地解析搜索结果,优先返回直接答案或知识图谱信息。
    \"\"\"
    print(f\"正在执行 [SerpApi] 网页搜索: {query}\")
    try:
        api_key = os.getenv(\"SERPAPI_API_KEY\")
        ifnot api_key:
            return\"错误:SERPAPI_API_KEY 未在 .env 文件中配置。\"
        params = {
            \"engine\": \"google\",
            \"q\": query,
            \"api_key\": api_key,
            \"gl\": \"cn\",   # 国家代码
            \"hl\": \"zh-cn\", # 语言代码
        }

        client = SerpApiClient(params)
        results = client.get_dict()

        # 智能解析:优先寻找最直接的答案
        if\"answer_box_list\"in results:
            return\"\
\".join(results[\"answer_box_list\"])
        if\"answer_box\"in results and\"answer\"in results[\"answer_box\"]:
            return results[\"answer_box\"][\"answer\"]
        if\"knowledge_graph\"in results and\"description\"in results[\"knowledge_graph\"]:
            return results[\"knowledge_graph\"][\"description\"]
        if\"organic_results\"in results and results[\"organic_results\"]:
            # 如果没有直接答案,则返回前三个有机结果的摘要
            snippets = [
                f\"[{i+1}] {res.get('title', '')}\
{res.get('snippet', '')}\"
                for i, res in enumerate(results[\"organic_results\"][:3])
            ]
            return\"\
\
\".join(snippets)

        returnf\"对不起,没有找到关于 '{query}' 的信息。\"
    except Exception as e:
        returnf\"搜索时发生错误: {e}\"
上述代码会优先检查 answer_box 或 knowledge_graph 等高价值信息,若存在则直接返回;否则退而求其次,返回前三个常规搜索结果的摘要。这种“智能解析”能为LLM提供更高质量的输入。
(2)构建通用的工具执行器当智能体需驾驭多种工具时(如搜索、计算、查库),我们需要一个统一的管理器来注册和调度。为此,创建 ToolExecutor 类。
from typing import Dict, Any
classToolExecutor:
    \"\"\"
    一个工具执行器,负责管理和执行工具。
    \"\"\"
    def__init__(self):
        self.tools: Dict[str, Dict[str, Any]] = {}
    defregisterTool(self, name: str, description: str, func: callable):
        \"\"\"
        向工具箱中注册一个新工具。
        \"\"\"
        if name in self.tools:
            print(f\"警告:工具 '{name}' 已存在,将被覆盖。\")
        self.tools[name] = {\"description\": description, \"func\": func}
        print(f\"工具 '{name}' 已注册。\")
    defgetTool(self, name: str) -> callable:
        \"\"\"
        根据名称获取一个工具的执行函数。
        \"\"\"
        return self.tools.get(name, {}).get(\"func\")
    defgetAvailableTools(self) -> str:
        \"\"\"
        获取所有可用工具的格式化描述字符串。
        \"\"\"
        return\"\
\".join([
            f\"- {name}: {info['description']}\"
            for name, info in self.tools.items()
        ])
(3)测试现在,将 search 工具注册到 ToolExecutor 中,并模拟一次调用验证流程。
# --- 工具初始化与使用示例 ---
if __name__ == '__main__':
    # 1. 初始化工具执行器
    toolExecutor = ToolExecutor()
    # 2. 注册我们的实战搜索工具
    search_description = \"一个网页搜索引擎。当你需要回答关于时事、事实以及在你的知识库中找不到的信息时,应使用此工具。\"
    toolExecutor.registerTool(\"Search\", search_description, search)

    # 3. 打印可用的工具
    print(\"\
--- 可用的工具 ---\")
    print(toolExecutor.getAvailableTools())
    # 4. 智能体的Action调用,这次我们问一个实时性的问题
    print(\"\
--- 执行 Action: Search['英伟达最新的GPU型号是什么'] ---\")
    tool_name = \"Search\"
    tool_input = \"英伟达最新的GPU型号是什么\"
    tool_function = toolExecutor.getTool(tool_name)
    if tool_function:
        observation = tool_function(tool_input)
        print(\"--- 观察 ---\")
        print(observation)
    else:
        print(f\"错误:未找到名为 '{tool_name}' 的工具。\")
>>>
工具 'Search' 已注册。
--- 可用的工具 ---
- Search: 一个网页搜索引擎。当你需要回答关于时事、事实以及在你的知识库中找不到的信息时,应使用此工具。
--- 执行 Action: Search['英伟达最新的GPU型号是什么'] ---
正在执行 [SerpApi] 网页搜索: 英伟达最新的GPU型号是什么
--- 观察 ---
[1] GeForce RTX 50 系列显卡
GeForce RTX™ 50 系列GPU 搭载NVIDIA Blackwell 架构,为游戏玩家和创作者带来全新玩法。RTX 50 系列具备强大的AI 算力,带来升级体验和更逼真的画面。
[2] 比较GeForce 系列最新一代显卡和前代显卡
比较最新一代RTX 30 系列显卡和前代的RTX 20 系列、GTX 10 和 900 系列显卡。查看规格、功能、技术支持等内容。
[3] GeForce 显卡| NVIDIA
DRIVE AGX. 强大的车载计算能力,适用于AI 驱动的智能汽车系统 · Clara AGX. 适用于创新型医疗设备和成像的AI 计算. 游戏和创作. GeForce. 探索显卡、游戏解决方案,AI ...
至此,我们已为智能体接入了连接互联网的 Search 工具,为ReAct循环奠定了坚实基础。
4.2.3 ReAct 智能体的编码实现
现在,我们将所有组件——LLM客户端与工具执行器——组装起来,构建一个完整的 ReAct 智能体。我们将通过 ReActAgent 类封装核心逻辑,并分模块讲解。
(1)系统提示词设计提示词是 ReAct 机制的基石,它为模型提供了行动指南。我们需要设计一个模板,动态注入可用工具、用户问题及历史交互记录。
# ReAct 提示词模板
REACT_PROMPT_TEMPLATE = \"\"\"
请注意,你是一个有能力调用外部工具的智能助手。
可用工具如下:
{tools}
请严格按照以下格式进行回应:
Thought: 你的思考过程,用于分析问题、拆解任务和规划下一步行动。
Action: 你决定采取的行动,必须是以下格式之一:
- `{{tool_name}}[{{tool_input}}]`:调用一个可用工具。
- `Finish[最终答案]`:当你认为已经获得最终答案时。
- 当你收集到足够的信息,能够回答用户的最终问题时,你必须在Action:字段后使用 Finish[最终答案] 来输出最终答案。
现在,请开始解决以下问题:
Question: {question}
History: {history}
\"\"\"
该模板定义了交互规范:
- 角色定义:“你是一个有能力调用外部工具的智能助手”。
- 工具清单 (
{tools}):告知模型可用的工具集。 - 格式规约 (
Thought/Action):强制模型输出结构化内容,便于代码解析。 - 动态上下文 (
{question}/{history}):注入原始问题与累积的交互历史。
(2)核心循环的实现ReActAgent 的核心是一个循环,不断执行“格式化提示 -> 调用LLM -> 执行动作 -> 整合结果”,直至任务完成或达上限。
classReActAgent:
    def__init__(self, llm_client: HelloAgentsLLM, tool_executor: ToolExecutor, max_steps: int = 5):
        self.llm_client = llm_client
        self.tool_executor = tool_executor
        self.max_steps = max_steps
        self.history = []
    defrun(self, question: str):
        \"\"\"
        运行ReAct智能体来回答一个问题。
        \"\"\"
        self.history = [] # 每次运行时重置历史记录
        current_step = 0
        while current_step < self.max_steps:
            current_step += 1
            print(f\"--- 第 {current_step} 步 ---\")
            # 1. 格式化提示词
            tools_desc = self.tool_executor.getAvailableTools()
            history_str = \"\
\".join(self.history)
            prompt = REACT_PROMPT_TEMPLATE.format(
                tools=tools_desc,
                question=question,
                history=history_str
            )
            # 2. 调用LLM进行思考
            messages = [{\"role\": \"user\", \"content\": prompt}]
            response_text = self.llm_client.think(messages=messages)

            ifnot response_text:
                print(\"错误:LLM未能返回有效响应。\")
                break
            # ... (后续的解析、执行、整合步骤)
run 方法是入口,其 while 循环构成了 ReAct 的主体,max_steps 则是防止无限循环的安全阀。
(3)输出解析器的实现LLM返回的是纯文本,我们需要提取 Thought 和 Action。这通过正则表达式辅助函数完成。
# (这些方法是 ReActAgent 类的一部分)
    def_parse_output(self, text: str):
        \"\"\"解析LLM的输出,提取Thought和Action。\"\"\"
        # Thought: 匹配到 Action: 或文本末尾
        thought_match = re.search(r\"Thought:\\s*(.*?)(?=\
Action:|$)\", text, re.DOTALL)
        # Action: 匹配到文本末尾
        action_match = re.search(r\"Action:\\s*(.*?)$\", text, re.DOTALL)
        thought = thought_match.group(1).strip() if thought_match elseNone
        action = action_match.group(1).strip() if action_match elseNone
        return thought, action
    def_parse_action(self, action_text: str):
        \"\"\"解析Action字符串,提取工具名称和输入。\"\"\"
        match = re.match(r\"(\\w+)\\[(.*)\\]\", action_text, re.DOTALL)
        if match:
            return match.group(1), match.group(2)
        returnNone, None
_parse_output:分离出Thought和Action。_parse_action:从Search[华为最新手机]中提取工具名与输入。
(4) 工具调用与执行
# (这段逻辑在 run 方法的 while 循环内)
            # 3. 解析LLM的输出
            thought, action = self._parse_output(response_text)

            if thought:
                print(f\"思考: {thought}\")
            ifnot action:
                print(\"警告:未能解析出有效的Action,流程终止。\")
                break
            # 4. 执行Action
            if action.startswith(\"Finish\"):
                # 如果是Finish指令,提取最终答案并结束
                final_answer = re.match(r\"Finish\\[(.*)\\]\", action).group(1)
                print(f\"最终答案: {final_answer}\")
                return final_answer
            tool_name, tool_input = self._parse_action(action)
            ifnot tool_name ornot tool_input:
                # ... 处理无效Action格式 ...
                continue
            print(f\"行动: {tool_name}[{tool_input}]\")
            tool_function = self.tool_executor.getTool(tool_name)
            ifnot tool_function:
                observation = f\"错误:未找到名为 '{tool_name}' 的工具。\"
            else:
                observation = tool_function(tool_input) # 调用真实工具
此代码是 Action 的执行中枢。若检测到 Finish 指令则流程终止;否则通过 tool_executor 获取并执行工具,得到 observation。
(5)观测结果的整合最后,将 Action 和 Observation 追加回历史记录,为下轮循环提供新上下文。
# (这段逻辑紧随工具调用之后,在 while 循环的末尾)
            print(f\"观察: {observation}\")

            # 将本轮的Action和Observation添加到历史记录中
            self.history.append(f\"Action: {action}\")
            self.history.append(f\"Observation: {observation}\")
        # 循环结束
        print(\"已达到最大步数,流程终止。\")
        returnNone
通过追加 Observation,智能体在下一轮能“看到”上一步的结果,从而进行新的思考。
(6)运行实例与分析完整的 ReActAgent 类代码可参考本书配套仓库。以下是一次真实运行记录:
工具 'Search' 已注册。
--- 第 1 步 ---
正在调用 xxxxxx 模型...
大语言模型响应成功:
Thought: 要回答这个问题,我需要查找华为最新发布的手机型号及其主要特点。这些信息可能在我的现有知识库之外,因此需要使用搜索引擎来获取最新数据。
Action: Search[华为最新手机型号及主要卖点]
思考: 要回答这个问题,我需要查找华为最新发布的手机型号及其主要特点。这些信息可能在我的现有知识库之外,因此需要使用搜索引擎来获取最新数据。
行动: Search[华为最新手机型号及主要卖点]
正在执行 [SerpApi] 网页搜索: 华为最新手机型号及主要卖点
观察: [1] 华为手机- 华为官网
智能手机 ; Mate 系列. 非凡旗舰 · HUAWEI Mate XTs. 非凡大师 ; Pura 系列. 先锋影像 · HUAWEI Pura 80 Pro+ ; Pocket 系列. 美学新篇. HUAWEI Pocket 2 ; nova 系列. 专业人像.
[2] 2025年华为手机哪一款性价比高?华为手机推荐与市场分析 ...
现在华为手机最大的卖点只剩下鸿蒙HarmonyOS系统,以及饱受争议的品牌信仰。 这里推荐目前值得入手的几款华为系列手机,根据不同预算自行选择:. 华为目前最受欢迎,也是搭载 ...
[3] 2025年华为新款手机哪个性价比高?10款华为新款手机推荐
选华为主要还是要推荐高端手机,Mate 70和Pura 70系列是最新发布的旗舰机型。 HUAWEI Mate 70. 优点是,拍照配置依旧顶级,全焦段覆盖,适合专业摄影,做工出色,户外抗摔 ...
--- 第 2 步 ---
正在调用 xxxxxx 模型...
大语言模型响应成功:
Thought: 根据搜索结果,华为最新发布的旗舰机型包括Mate 70和Pura 80 Pro+。为了确定最新型号及其主要卖点,我将重点放在这些信息上。从提供的链接来看,Mate 70系列和Pura 80 Pro+都是近期发布的产品,但具体哪一个是“最新”还需要进一步确认。同时,我可以从这些信息中提取出它们的主要
卖点。
Action: Finish[根据最新信息,华为的最新手机可能是HUAWEI Pura 80 Pro+或HUAWEI Mate 70。其中,HUAWEI Mate 70的主要卖点包括顶级的拍照配置,全焦段覆盖,适合专业摄影,做工出色,并且具有良好的户外抗摔性能。而HUAWEI Pura 80 Pro+则强调了先锋影像技术。]
思考: 根据搜索结果,华为最新发布的旗舰机型包括Mate 70和Pura 80 Pro+。为了确定最新型号及其主要卖点,我将重点放在这些信息上。从提供的链接来看,Mate 70系列和Pura 80 Pro+都是近期发布的产品,但具体哪一个是“最新”还需要进一步确认。同时,我可以从这些信息中提取出它们的主要
卖点。
最终答案: 根据最新信息,华为的最新手机可能是HUAWEI Pura 80 Pro+或HUAWEI Mate 70。其中,HUAWEI Mate 70的主要卖点包括顶级的拍照配置,全焦段覆盖,适合专业摄影,做工出色,并且具有良好的户外抗摔性能。而HUAWEI Pura 80 Pro+则强调了先锋影像技术。
从输出日志可见,智能体清晰展示了思考链条:首先意识到知识盲区,调用搜索工具;随后基于结果推理总结,在两步内得出答案。值得注意的是,由于模型知识与互联网信息动态更新,你的运行结果可能略有差异。截至编写时的2025年9月8日,搜索结果提及的Mate 70与Pura 80 Pro+确为当时华为最新旗舰。这充分印证了ReAct范式在处理时效性问题上的威力。
4.2.4 ReAct 的特点、局限性与调试技巧
通过亲手实现 ReAct 智能体,我们不仅掌握了流程,更应洞察其内在机制。任何技术都有两面性,本节将进行总结。
(1)ReAct 的主要特点
- 高可解释性:ReAct 最大的优点之一是透明。通过
Thought链,我们能清晰追踪智能体的“心路历程”——为何选此工具,下步计划为何。这对理解与调试至关重要。 - 动态规划与纠错能力:不同于一次性规划,ReAct 是“走一步看一步”。它能根据
Observation动态调整后续Thought和Action。若搜索结果不佳,它可在下步修正关键词重试。 - 工具协同能力:ReAct 将 LLM 的推理与工具执行无缝结合。LLM 运筹帷幄,工具冲锋陷阵,二者协同突破了单一 LLM 在时效性与准确性上的局限。
(2)ReAct 的固有局限性
* 对LLM能力的强依赖:流程成败高度依赖底层 LLM。若模型逻辑推理或指令遵循能力不足,极易在 Thought 环节规划错误,或在 Action 环节生成非法指令。
* 执行效率问题:串行的“思考-行动”循环意味着多次 LLM 调用,伴随着网络延迟与计算成本。复杂任务可能耗时较长。
* 提示词的脆弱性:机制稳定运行依赖精心设计的提示词模板。微小变动都可能影响模型行为,且并非所有模型都能持续稳定遵循格式。
* 可能陷入局部最优:步进式决策缺乏全局视野,可能导致智能体因眼前 Observation 误入歧途,甚至陷入死循环。
(3)调试技巧当智能体行为异常时,可从以下维度排查:
- 检查完整提示词:调用 LLM 前,打印最终格式化好的完整提示词,追溯决策源头。
- 分析原始输出:解析失败时,务必打印 LLM 返回的原始文本,判断是格式遵循问题还是解析逻辑错误。
- 验证工具I/O:检查智能体生成的
tool_input是否符合工具预期,同时确保工具返回的observation智能体可理解。 - 调整Few-shot示例:若模型频繁出错,可在提示词中加入成功案例,引导模型遵循指令。
- 尝试不同模型或参数:更换更强模型或调低
temperature参数(如设为0)以提升确定性。
4.3 Plan-and-Solve
在掌握了 ReAct 这种反应式范式后,我们将探讨另一种风格迥异的方法——Plan-and-Solve。顾名思义,该范式将任务处理明确划分为两个阶段:先规划,后执行。 若说 ReAct 像侦探根据线索步步推理,Plan-and-Solve 则像建筑师先绘蓝图后施工。目前许多主流 Agent 模式都融入了这一设计理念。
4.3.1 Plan-and-Solve 的工作原理
Plan-and-Solve Prompting 由 Lei Wang 于2023年提出[2],旨在解决思维链在复杂任务中易“跑偏”的问题。 与 ReAct 不同,Plan-and-Solve 将流程解耦为两个核心阶段,如图4.2所示:规划阶段: 智能体首先接收用户问题,暂不直接求解,而是将问题分解,制定出清晰的分步行动计划。该计划本身即是一次 LLM 调用的产物。执行阶段: 获得计划后,智能体进入执行阶段,严格按计划逐步执行。每一步执行可能是一次独立 LLM 调用或对上一步结果的加工,直至所有步骤完成。 这种“先谋后动”策略使智能体在处理复杂任务时保持更高的目标一致性,避免迷失方向。 形式化表达如下:首先,规划模型 根据原始问题 生成含 步的计划 :
随后,执行模型 逐一完成步骤。对于第 步,其解决方案 依赖于原始问题、计划及前序结果:
最终答案即最后一步结果 。
图 4.2 Plan-and-Solve 范式的两阶段工作流
Plan-and-Solve 尤其适用于结构性强、可清晰分解的复杂任务,如多步数学题、多源信息整合报告、代码生成等。
4.3.2 规划阶段
为凸显该范式在结构化推理上的优势,我们将不使用工具,而是通过提示词设计完成一个推理任务。 目标问题: “一个水果店周一卖出了15个苹果。周二卖出的苹果数量是周一的两倍。周三卖出的数量比周二少了5个。请问这三天总共卖出了多少个苹果?” 该问题包含清晰逻辑链条,智能体需:
规划阶段:分解为三个计算步骤(周二销量、周三销量、总销量)。
执行阶段:按计划逐步计算,传递结果,最终求和。 规划阶段的目标是生成结构化计划,便于代码解析执行。
PLANNER_PROMPT_TEMPLATE = \"\"\"
你是一个顶级的AI规划专家。你的任务是将用户提出的复杂问题分解成一个由多个简单步骤组成的行动计划。
请确保计划中的每个步骤都是一个独立的、可执行的子任务,并且严格按照逻辑顺序排列。
你的输出必须是一个Python列表,其中每个元素都是一个描述子任务的字符串。
问题: {question}
请严格按照以下格式输出你的计划,```python与```作为前后缀是必要的:
```python
[\"步骤1\", \"步骤2\", \"步骤3\", ...]
该提示词通过角色设定、任务描述与格式约束(Python列表),确保输出稳定可靠。
接着,封装 `Planner` 类:
```python
# 假定 llm_client.py 中的 HelloAgentsLLM 类已经定义好
# from llm_client import HelloAgentsLLM
class Planner:
    def __init__(self, llm_client):
        self.llm_client = llm_client
    def plan(self, question: str) -> list[str]:
        \"\"\"
        根据用户问题生成一个行动计划。
        \"\"\"
        prompt = PLANNER_PROMPT_TEMPLATE.format(question=question)

        # 为了生成计划,我们构建一个简单的消息列表
        messages = [{\"role\": \"user\", \"content\": prompt}]

        print(\"--- 正在生成计划 ---\")
        # 使用流式输出来获取完整的计划
        response_text = self.llm_client.think(messages=messages) or \"\"

        print(f\"计划已生成:\
{response_text}\")

        # 解析LLM输出的列表字符串
        try:
            # 找到```python和```之间的内容
            plan_str = response_text.split(\"```python\")[1].split(\"```\")[0].strip()
            # 使用ast.literal_eval来安全地执行字符串,将其转换为Python列表
            plan = ast.literal_eval(plan_str)
            return plan if isinstance(plan, list) else []
        except (ValueError, SyntaxError, IndexError) as e:
            print(f\"解析计划时出错: {e}\")
            print(f\"原始响应: {response_text}\")
            return []
        except Exception as e:
            print(f\"解析计划时发生未知错误: {e}\")
            return []
4.3.3 执行器与状态管理
规划器生成蓝图后,执行器 (Executor) 需逐一落实任务,并承担状态管理职责:记录每步结果,作为后续步骤的上下文。 执行器提示词需包含:原始问题、完整计划、历史步骤结果及当前步骤。
EXECUTOR_PROMPT_TEMPLATE = \"\"\"
你是一位顶级的AI执行专家。你的任务是严格按照给定的计划,一步步地解决问题。
你将收到原始问题、完整的计划、以及到目前为止已经完成的步骤和结果。
请你专注于解决“当前步骤”,并仅输出该步骤的最终答案,不要输出任何额外的解释或对话。
# 原始问题:
{question}
# 完整计划:
{plan}
# 历史步骤与结果:
{history}
# 当前步骤:
{current_step}
请仅输出针对“当前步骤”的回答:
\"\"\"
将逻辑封装至 Executor 类,循环遍历计划并维护历史:
classExecutor:
    def__init__(self, llm_client):
        self.llm_client = llm_client
    defexecute(self, question: str, plan: list[str]) -> str:
        \"\"\"
        根据计划,逐步执行并解决问题。
        \"\"\"
        history = \"\"# 用于存储历史步骤和结果的字符串

        print(\"\
--- 正在执行计划 ---\")

        for i, step in enumerate(plan):
            print(f\"\
-> 正在执行步骤 {i+1}/{len(plan)}: {step}\")

            prompt = EXECUTOR_PROMPT_TEMPLATE.format(
                question=question,
                plan=plan,
                history=history if history else\"无\", # 如果是第一步,则历史为空
                current_step=step
            )

            messages = [{\"role\": \"user\", \"content\": prompt}]

            response_text = self.llm_client.think(messages=messages) or\"\"

            # 更新历史记录,为下一步做准备
            history += f\"步骤 {i+1}: {step}\
结果: {response_text}\
\
\"

            print(f\"步骤 {i+1} 已完成,结果: {response_text}\")
        # 循环结束后,最后一步的响应就是最终答案
        final_answer = response_text
        return final_answer
最后,整合为 PlanAndSolveAgent 类:
classPlanAndSolveAgent:
    def__init__(self, llm_client):
        \"\"\"
        初始化智能体,同时创建规划器和执行器实例。
        \"\"\"
        self.llm_client = llm_client
        self.planner = Planner(self.llm_client)
        self.executor = Executor(self.llm_client)
    defrun(self, question: str):
        \"\"\"
        运行智能体的完整流程:先规划,后执行。
        \"\"\"
        print(f\"\
--- 开始处理问题 ---\
问题: {question}\")

        # 1. 调用规划器生成计划
        plan = self.planner.plan(question)

        # 检查计划是否成功生成
        ifnot plan:
            print(\"\
--- 任务终止 --- \
无法生成有效的行动计划。\")
            return
        # 2. 调用执行器执行计划
        final_answer = self.executor.execute(question, plan)

        print(f\"\
--- 任务完成 ---\
最终答案: {final_answer}\")
4.3.4 运行实例与分析
完整的代码同样参考本书配套的代码仓库 code 文件夹,这里只演示最终结果。
--- 开始处理问题 ---
问题: 一个水果店周一卖出了15个苹果。周二卖出的苹果数量是周一的两倍。周三卖出的数量比周二少了5个。请问这三天总共卖出了多少个苹果?
--- 正在生成计划 ---
正在调用 xxxx 模型...
大语言模型响应成功:
```python
[\"计算周一卖出的苹果数量: 15个\", \"计算周二卖出的苹果数量: 周一数量 × 2 = 15 × 2 = 30个\", \"计算周三卖出的苹果数量: 周二数量 - 5 = 30 - 5 = 25个\", \"计算三天总销量: 周一 + 周二 + 周三 = 15 + 30 + 25 = 70个\"]
计划已生成:
[\"计算周一卖出的苹果数量: 15个\", \"计算周二卖出的苹果数量: 周一数量 × 2 = 15 × 2 = 30个\", \"计算周三卖出的苹果数量: 周二数量 - 5 = 30 - 5 = 25个\", \"计算三天总销量: 周一 + 周二 + 周三 = 15 + 30 + 25 = 70个\"]
--- 正在执行计划 ---
-> 正在执行步骤 1/4: 计算周一卖出的苹果数量: 15个
正在调用 xxxx 模型...
大语言模型响应成功:
15
步骤 1 已完成,结果: 15
-> 正在执行步骤 2/4: 计算周二卖出的苹果数量: 周一数量 × 2 = 15 × 2 = 30个
正在调用 xxxx 模型...
大语言模型响应成功:
30
步骤 2 已完成,结果: 30
-> 正在执行步骤 3/4: 计算周三卖出的苹果数量: 周二数量 - 5 = 30 - 5 = 25个
正在调用 xxxx 模型...
大语言模型响应成功:
25
步骤 3 已完成,结果: 25
-> 正在执行步骤 4/4: 计算三天总销量: 周一 + 周二 + 周三 = 15 + 30 + 25 = 70个
正在调用 xxxx 模型...
大语言模型响应成功:
70
步骤 4 已完成,结果: 70
--- 任务完成 ---
最终答案: 70
从上面的输出日志中,我们可以清晰地看到 Plan-and-Solve 范式的工作流程:
1. **规划阶段**: 智能体首先调用 `Planner`,成功地将复杂的应用题分解成了一个包含四个逻辑步骤的 Python 列表。这个结构化的计划为后续的执行奠定了基础。
2. **执行阶段**: `Executor` 严格按照生成的计划,一步一步地向下执行。在每一步中,它都将历史结果作为上下文,确保了信息的正确传递(例如,步骤2正确地使用了步骤1的结果“15个”,步骤3也正确使用了步骤2的结果“30个”)。
3. **结果**:整个过程逻辑清晰,步骤明确,最终智能体准确地得出了正确答案“70个”。
## 4.4 Reflection
在我们已经实现的 ReAct 和 Plan-and-Solve 范式中,智能体一旦完成了任务,其工作流程便告结束。然而,它们生成的初始答案,无论是行动轨迹还是最终结果,都可能存在谬误或有待改进之处。Reflection 机制的核心思想,正是为智能体引入一种**事后(post-hoc)的自我校正循环**,使其能够像人类一样,审视自己的工作,发现不足,并进行迭代优化。
### 4.4.1 Reflection 机制的核心思想
Reflection 机制的灵感来源于人类的学习过程:我们完成初稿后会进行校对,解出数学题后会进行验算。这一思想在多个研究中得到了体现,例如 Shinn, Noah 在2023年提出的 Reflexion 框架[3]。其核心工作流程可以概括为一个简洁的三步循环:**执行 -> 反思 -> 优化**。
1. **执行 (Execution)**:首先,智能体使用我们熟悉的方法(如 ReAct 或 Plan-and-Solve)尝试完成任务,生成一个初步的解决方案或行动轨迹。这可以看作是“初稿”。
2. **反思 (Reflection)**:接着,智能体进入反思阶段。它会调用一个独立的、或者带有特殊提示词的大语言模型实例,来扮演一个“评审员”的角色。这个“评审员”会审视第一步生成的“初稿”,并从多个维度进行评估,例如:
* **事实性错误**:是否存在与常识或已知事实相悖的内容?
* **逻辑漏洞**:推理过程是否存在不连贯或矛盾之处?
* **效率问题**:是否有更直接、更简洁的路径来完成任务?
* **遗漏信息**:是否忽略了问题的某些关键约束或方面? 根据评估,它会生成一段结构化的**反馈 (Feedback)**,指出具体的问题所在和改进建议。
3. **优化 (Refinement)**:最后,智能体将“初稿”和“反馈”作为新的上下文,再次调用大语言模型,要求它根据反馈内容对初稿进行修正,生成一个更完善的“修订稿”。
如图4.3所示,这个循环可以重复进行多次,直到反思阶段不再发现新的问题,或者达到预设的迭代次数上限。我们可以将这个迭代优化的过程形式化地表达出来。假设 是第 次迭代产生的输出( 为初始输出),反思模型 会生成针对 的反馈 :
随后,优化模型 会结合原始任务、上一版输出以及反馈,生成新一版的输出 :
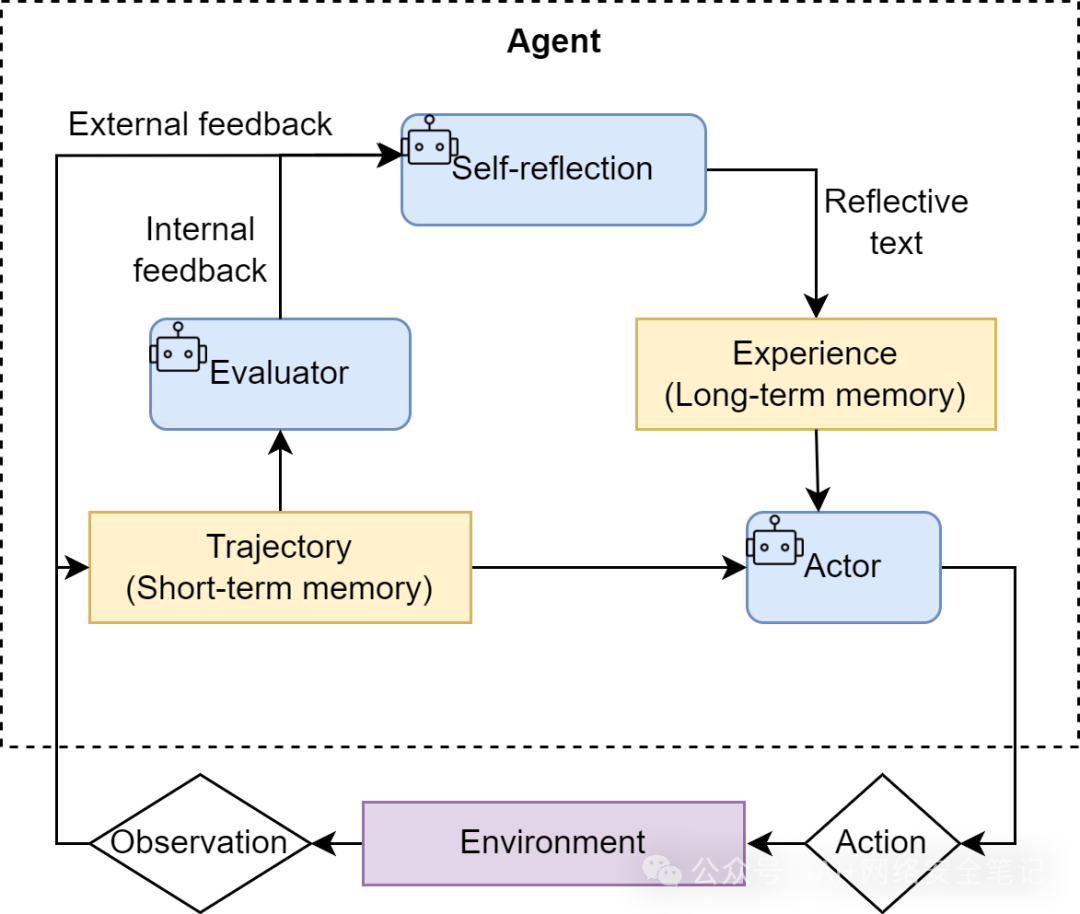
图 4.3 Reflection 机制中的“执行-反思-优化”迭代循环
与前两种范式相比,Reflection 的价值在于:
* 它为智能体提供了一个内部纠错回路,使其不再完全依赖于外部工具的反馈(ReAct 的 Observation),从而能够修正更高层次的逻辑和策略错误。
* 它将一次性的任务执行,转变为一个持续优化的过程,显著提升了复杂任务的最终成功率和答案质量。
* 它为智能体构建了一个临时的**“短期记忆”**。整个“执行-反思-优化”的轨迹形成了一个宝贵的经验记录,智能体不仅知道最终答案,还记得自己是如何从有缺陷的初稿迭代到最终版本的。更进一步,这个记忆系统还可以是**多模态的**,允许智能体反思和修正文本以外的输出(如代码、图像等),为构建更强大的多模态智能体奠定了基础。
### 4.4.2 案例设定与记忆模块设计
为了在实战中体现 Reflection 机制,我们将引入记忆管理机制,因为reflection通常对应着信息的存储和提取,如果上下文足够长的情况,想让“评审员”直接获取所有的信息然后进行反思往往会传入很多冗余信息。这一步实践我们主要完成**代码生成与迭代优化**。
这一步的目标任务是:“编写一个Python函数,找出1到n之间所有的素数 (prime numbers)。”
这个任务是检验 Reflection 机制的绝佳场景:
1. **存在明确的优化路径**:大语言模型初次生成的代码很可能是一个简单但效率低下的递归实现。
2. **反思点清晰**:可以通过反思发现其“时间复杂度过高”或“存在重复计算”的问题。
3. **优化方向明确**:可以根据反馈,将其优化为更高效的迭代版本或使用备忘录模式的版本。
Reflection 的核心在于迭代,而迭代的前提是能够记住之前的尝试和获得的反馈。因此,一个“短期记忆”模块是实现该范式的必需品。这个记忆模块将负责存储每一次“执行-反思”循环的完整轨迹。
from typing import List, Dict, Any, Optional
class Memory:
\"\"\"
一个简单的短期记忆模块,用于存储智能体的行动与反思轨迹。
\"\"\"
def init(self):
\"\"\"
初始化一个空列表来存储所有记录。
\"\"\"
self.records: List[Dict[str, Any]] = []
def add_record(self, record_type: str, content: str):
\"\"\"
向记忆中添加一条新记录。
参数:
- record_type (str): 记录的类型 ('execution' 或 'reflection')。
- content (str): 记录的具体内容 (例如,生成的代码或反思的反馈)。
\"\"\"
record = {\"type\": record_type, \"content\": content}
self.records.append(record)
print(f\"记忆已更新,新增一条 '{record_type}' 记录。\")
def get_trajectory(self) -> str:
\"\"\"
将所有记忆记录格式化为一个连贯的字符串文本,用于构建提示词。
\"\"\"
trajectory_parts = []
for record in self.records:
if record['type'] == 'execution':
trajectory_parts.append(f\"--- 上一轮尝试 (代码) ---\
{record['content']}\")
elif record['type'] == 'reflection':
trajectory_parts.append(f\"--- 评审员反馈 ---\
{record['content']}\")
return\"\
\
\".join(trajectory_parts)
def get_last_execution(self) -> Optional[str]:
\"\"\"
获取最近一次的执行结果 (例如,最新生成的代码)。
如果不存在,则返回 None。
\"\"\"
for record in reversed(self.records):
if record['type'] == 'execution':
return record['content']
returnNone
这个 `Memory` 类的设计比较简洁,主体是这样的:

* 使用一个列表 `records` 来按顺序存储每一次的行动和反思。
* `add_record` 方法负责向记忆中添加新的条目。
* `get_trajectory` 方法是核心,它将记忆轨迹“序列化”成一段文本,可以直接插入到后续的提示词中,为模型的反思和优化提供完整的上下文。
* `get_last_execution` 方便我们获取最新的“初稿”以供反思。

### 4.4.3 Reflection 智能体的编码实现

有了 `Memory` 模块作为基础,我们现在可以着手构建 `ReflectionAgent` 的核心逻辑。整个智能体的工作流程将围绕我们之前讨论的“执行-反思-优化”循环展开,并通过精心设计的提示词来引导大语言模型扮演不同的角色。

(1)提示词设计

与之前的范式不同,Reflection 机制需要多个不同角色的提示词来协同工作。

1. **初始执行提示词 (Execution Prompt)** :这是智能体首次尝试解决问题的提示词,内容相对直接,只要求模型完成指定任务。
INITIAL_PROMPT_TEMPLATE = \"\"\"
你是一位资深的Python程序员。请根据以下要求,编写一个Python函数。
你的代码必须包含完整的函数签名、文档字符串,并遵循PEP 8编码规范。
要求: {task}
请直接输出代码,不要包含任何额外的解释。
\"\"\"
2. **反思提示词 (Reflection Prompt)** :这个提示词是 Reflection 机制的灵魂。它指示模型扮演“代码评审员”的角色,对上一轮生成的代码进行批判性分析,并提供具体的、可操作的反馈。
REFLECT_PROMPT_TEMPLATE = \"\"\"
你是一位极其严格的代码评审专家和资深算法工程师,对代码的性能有极致的要求。
你的任务是审查以下Python代码,并专注于找出其在算法效率上的主要瓶颈。
原始任务:
{task}
待审查的代码:
{code}
请分析该代码的时间复杂度,并思考是否存在一种算法上更优的解决方案来显著提升性能。
如果存在,请清晰地指出当前算法的不足,并提出具体的、可行的改进算法建议(例如,使用筛法替代试除法)。
如果代码在算法层面已经达到最优,才能回答“无需改进”。
请直接输出你的反馈,不要包含任何额外的解释。
\"\"\"
3. **优化提示词 (Refinement Prompt)** :当收到反馈后,这个提示词将引导模型根据反馈内容,对原有代码进行修正和优化。
REFINE_PROMPT_TEMPLATE = \"\"\"
你是一位资深的Python程序员。你正在根据一位代码评审专家的反馈来优化你的代码。
原始任务:
{task}
你上一轮尝试的代码:
{last_code_attempt}
评审员的反馈:
请根据评审员的反馈,生成一个优化后的新版本代码。
你的代码必须包含完整的函数签名、文档字符串,并遵循PEP 8编码规范。
请直接输出优化后的代码,不要包含任何额外的解释。
\"\"\"
(2)智能体封装与实现

现在,我们将这套提示词逻辑和 `Memory` 模块整合到 `ReflectionAgent` 类中。
假设 llm_client.py 和 memory.py 已定义
from llm_client import HelloAgentsLLM
from memory import Memory
class ReflectionAgent:
def init(self, llm_client, max_iterations=3):
self.llm_client = llm_client
self.memory = Memory()
self.max_iterations = max_iterations
def run(self, task: str):
print(f\"\
--- 开始处理任务 ---\
任务: {task}\")
# --- 1. 初始执行 ---
print(\"\
--- 正在进行初始尝试 ---\")
initial_prompt = INITIAL_PROMPT_TEMPLATE.format(task=task)
initial_code = self._get_llm_response(initial_prompt)
self.memory.add_record(\"execution\", initial_code)
# --- 2. 迭代循环:反思与优化 ---
for i in range(self.max_iterations):
print(f\"\
--- 第 {i+1}/{self.max_iterations} 轮迭代 ---\")
# a. 反思
print(\"\
-> 正在进行反思...\")
last_code = self.memory.get_last_execution()
reflect_prompt = REFLECT_PROMPT_TEMPLATE.format(task=task, code=last_code)
feedback = self._get_llm_response(reflect_prompt)
self.memory.add_record(\"reflection\", feedback)
# b. 检查是否需要停止
if\"无需改进\"in feedback:
print(\"\
反思认为代码已无需改进,任务完成。\")
break
# c. 优化
print(\"\
-> 正在进行优化...\")
refine_prompt = REFINE_PROMPT_TEMPLATE.format(
task=task,
last_code_attempt=last_code,
feedback=feedback
)
refined_code = self._get_llm_response(refine_prompt)
self.memory.add_record(\"execution\", refined_code)
final_code = self.memory.get_last_execution()
print(f\"\
--- 任务完成 ---\
最终生成的代码:\
python\
{final_code}\
\")
return final_code
def _get_llm_response(self, prompt: str) -> str:
\"\"\"一个辅助方法,用于调用LLM并获取完整的流式响应。\"\"\"
messages = [{\"role\": \"user\", \"content\": prompt}]
response_text = self.llm_client.think(messages=messages) or\"\"
return response_text
### 4.4.4 运行实例与分析

完整的代码同样参考本书配套的代码仓库 `code` 文件夹,这里提供一个输出实例。
--- 开始处理任务 ---
任务: 编写一个Python函数,找出1到n之间所有的素数 (prime numbers)。
--- 正在进行初始尝试 ---
正在调用 xxxxxx 模型...
大语言模型响应成功:
def find_primes(n):
    ...
    return primes
记忆已更新,新增一条 'execution' 记录。
--- 第 1/2 轮迭代 ---
-> 正在进行反思...
正在调用 xxxxxx 模型...
大语言模型响应成功:
当前代码的时间复杂度为O(n * sqrt(n))。虽然对于较小的n值,这种实现是可以接受的,但当n非常大时,性能会显著下降。主要瓶颈在于每个数都需要进行试除法检查,这导致了较高的时间开销。
建议使用埃拉托斯特尼筛法(Sieve of Eratosthenes),该算法的时间复杂度为O(n log(log n)),能够显著提高查找素数的效率。
改进后的代码如下:
def find_primes(n):
    ...
    return primes
记忆已更新,新增一条 'reflection' 记录。
-> 正在进行优化...
正在调用 xxxxxx 模型...
大语言模型响应成功:
def find_primes(n):
    ...
    return primes
记忆已更新,新增一条 'execution' 记录。
--- 第 2/2 轮迭代 ---
-> 正在进行反思...
正在调用 xxxxxx 模型...
大语言模型响应成功:
当前代码使用了Eratosthenes筛法,时间复杂度为O(n log log n),空间复杂度为O(n)。此算法在寻找1到n之间的所有素数时已经非常高效,通常情况下无需进一步优化。但在某些特定场景下,可以考虑以下改进:
1. 分段筛法(Segmented Sieve):适用于n非常大但内存有限的情况。将区间分成多个小段,每段分别用筛法处理,减少内存使用。
2. 奇数筛法(Odd Number Sieve):除了2以外,所有素数都是奇数。可以在初始化is_prime数组时只标记奇数,这样可以将空间复杂度降低一半,同时减少一些不必要的计算。
然而,这些改进对于大多数应用场景来说并不是必需的,因为标准的Eratosthenes筛法已经足够高效。因此,在一般情况下,无需改进。
记忆已更新,新增一条 'reflection' 记录。
反思认为代码已无需改进,任务完成。
--- 任务完成 ---
最终生成的代码:
def find_primes(n):
    \"\"\"
    Finds all prime numbers between 1 and n using the Sieve of Eratosthenes algorithm.

    :param n: The upper limit of the range to find prime numbers.
    :return: A list of all prime numbers between 1 and n.
    \"\"\"
    if n < 2:
        return []

    is_prime = [True] * (n + 1)
    is_prime[0] = is_prime[1] = False

    p = 2
    while p * p <= n:
        if is_prime[p]:
            for i in range(p * p, n + 1, p):
                is_prime[i] = False
        p += 1

    primes = [num for num in range(2, n + 1) if is_prime[num]]
    return primes
```
这个运行实例展示了 Reflection 机制是如何驱动智能体进行深度优化的:
- 有效的“批判”是优化的前提:在第一轮反思中,由于我们使用了“极其严格”且“专注于算法效率”的提示词,智能体没有满足于功能正确的初版代码,而是精准地指出了其
O(n * sqrt(n))的时间复杂度瓶颈,并提出了算法层面的改进建议——埃拉托斯特尼筛法。 - 迭代式改进: 智能体在接收到明确的反馈后,于优化阶段成功地实现了更高效的筛法,将算法复杂度降至
O(n log log n),完成了第一次有意义的自我迭代。 - 收敛与终止: 在第二轮反思中,智能体面对已经高效的筛法,展现出了更深层次的知识。它不仅肯定了当前算法的效率,甚至还提及了分段筛法等更高级的优化方向,但最终做出了“在一般情况下无需改进”的正确判断。这个判断触发了我们的终止条件,使优化过程得以收敛。
这个案例充分证明,一个设计良好的 Reflection 机制,其价值不仅在于修复错误,更在于驱动解决方案在质量和效率上实现阶梯式的提升,这使其成为构建复杂、高质量智能体的关键技术之一。
4.4.5 Reflection 机制的成本收益分析
尽管 Reflection 机制在提升任务解决质量上表现出色,但这种能力的获得并非没有代价。在实际应用中,我们需要权衡其带来的收益与相应的成本。
(1)主要成本
- 模型调用开销增加:这是最直接的成本。每进行一轮迭代,至少需要额外调用两次大语言模型(一次用于反思,一次用于优化)。如果迭代多轮,API 调用成本和计算资源消耗将成倍增加。
- 任务延迟显著提高:Reflection 是一个串行过程,每一轮的优化都必须等待上一轮的反思完成。这使得任务的总耗时显著延长,不适合对实时性要求高的场景。
- 提示工程复杂度上升:如我们的案例所示,Reflection 的成功在很大程度上依赖于高质量、有针对性的提示词。为“执行”、“反思”、“优化”等不同阶段设计和调试有效的提示词,需要投入更多的开发精力。
(2)核心收益
- 解决方案质量的跃迁:最大的收益在于,它能将一个“合格”的初始方案,迭代优化成一个“优秀”的最终方案。这种从功能正确到性能高效、从逻辑粗糙到逻辑严谨的提升,在很多关键任务中是至关重要的。
- 鲁棒性与可靠性增强:通过内部的自我纠错循环,智能体能够发现并修复初始方案中可能存在的逻辑漏洞、事实性错误或边界情况处理不当等问题,从而大大提高了最终结果的可靠性。
综上所述,Reflection 机制是一种典型的“以成本换质量”的策略。它非常适合那些对最终结果的质量、准确性和可靠性有极高要求,且对任务完成的实时性要求相对宽松的场景。例如:
- 生成关键的业务代码或技术报告。
- 在科学研究中进行复杂的逻辑推演。
- 需要深度分析和规划的决策支持系统。
反之,如果应用场景需要快速响应,或者一个“大致正确”的答案就已经足够,那么使用更轻量的 ReAct 或 Plan-and-Solve 范式可能会是更具性价比的选择。
4.5 本章小结
在本章中,以第三章掌握的大语言模型知识为基础,我们通过“亲手造轮子”的方式,从零开始编码实现了三种业界经典的智能体构建范式:ReAct、Plan-and-Solve 与 Reflection。我们不仅探索了它们的核心工作原理,还通过具体的实战案例,深入了解了各自的优势、局限与适用场景。
核心知识点回顾:
- ReAct:我们构建了一个能与外部世界交互的 ReAct 智能体。通过“思考-行动-观察”的动态循环,它成功地利用搜索引擎回答了自身知识库无法覆盖的实时性问题。其核心优势在于环境适应性和动态纠错能力,使其成为处理探索性、需要外部工具输入的任务的首选。
- Plan-and-Solve:我们实现了一个先规划后执行的 Plan-and-Solve 智能体,并利用它解决了需要多步推理的数学应用题。它将复杂的任务分解为清晰的步骤,然后逐一执行。其核心优势在于结构性和稳定性,特别适合处理逻辑路径确定、内部推理密集的任务。
- Reflection (自我反思与迭代):我们构建了一个具备自我优化能力的 Reflection 智能体。通过引入“执行-反思-优化”的迭代循环,它成功地将一个效率较低的初始代码方案,优化为了一个算法上更优的高性能版本。其核心价值在于能显著提升解决方案的质量,适用于对结果的准确性和可靠性有极高要求的场景。
本章探讨的三种范式,代表了智能体解决问题的三种不同策略,如表4.1所示。在实际应用中,选择哪一种,取决于任务的核心需求:
表 4.1 不同 Agent Loop 的选择策略
至此,我们已经掌握了构建单个智能体的核心技术。为了过渡知识,以及对实际应用更加深入。下一节我们将会探索不同低代码平台的使用方式以及轻代码构建agent的方案。
参考文献
[1] Yao S, Zhao J, Yu D, et al. React: Synergizing reasoning and acting in language models[C]//International Conference on Learning Representations (ICLR). 2023.
[2] Wang L, Xu W, Lan Y, et al. Plan-and-solve prompting: Improving zero-shot chain-of-thought reasoning by large language models[J]. arXiv preprint arXiv:2305.04091, 2023.
[3] Shinn N, Cassano F, Gopinath A, et al. Reflexion: Language agents with verbal reinforcement learning[J]. Advances in Neural Information Processing Systems, 2023, 36: 8634-8652.

版权声明
本站仅做备份收录,仅供研究与教学参考之用。
读者将信息用于其他用途的,全部法律及连带责任由读者自行承担,本站不承担任何责任。







评论